Distributed tracing: como ler um trace, achar o span lento e chegar ao log do erro usando KeepWatch
 Autor: Pedro Tebaldi PM do KeepGreen
Quando o alerta avisa que o checkout ficou lento, o painel de métricas confirma o p95 subindo. Nenhum dos dois diz em qual dos seis serviços do pedido o tempo foi parar. Essa resposta está no trace, o registro que o distributed tracing guarda do caminho de cada requisição pelos serviços. O difícil é saber onde olhar dentro dele.
Segundo a pesquisa de observabilidade da Grafana Labs de 2025, 57% das organizações já coletam traces, contra 95% que coletam métricas. Coletar não basta, porque um trace de checkout tem dezenas de spans e a leitura sem método costuma parar no span errado.
Este tutorial usa três traces reais do KeepWatch, a plataforma de observabilidade de aplicações da OpServices. Os três são um checkout normal, outro quatro vezes mais lento e uma reserva que falhou. Os seis passos seguem a ordem em que o plantão investiga.
Todas as telas vêm do laboratório do KeepWatch. Loja e Viagens são aplicações de demonstração que enviam telemetria por OTLP; os números citados vêm dessas execuções.
O que um trace registra e em que ordem lê-lo
Cada requisição gera um trace, que é o caminho completo dela pelos serviços. O trace se divide em spans, um para cada operação: uma chamada HTTP, uma consulta ao banco, um trecho de código. Todos os spans da mesma requisição levam o mesmo trace_id.
Ler um trace é responder, nesta ordem: qual requisição olhar, onde o tempo foi gasto, qual span falhou e o que o log dele registrou.
A relação entre span pai e filho e a anatomia do span campo a campo estão no guia de traces na observabilidade. Já a implantação do distributed tracing, da instrumentação ao backend, é tema do post sobre como funciona o rastreamento distribuído. Aqui o ponto de partida é um trace pronto na tela.
Quem costura tudo é o trace_id. Ele viaja entre os serviços no cabeçalho traceparent, definido pela especificação Trace Context do W3C.
Nesse cabeçalho, o identificador do trace ocupa 32 caracteres hexadecimais e o do span pai ocupa 16. O identificador de 32 caracteres é o mesmo que aparece no topo de cada trace e que liga o trace ao log no passo 6.
Essa lógica vale para qualquer ferramenta que leia dados do OpenTelemetry, já que o formato do span vem do padrão e não da interface.
Passo 1: ache o trace certo, não o mais recente
Em seis horas, só o serviço loja-web do laboratório gerou 28.370 traces. Abrir o mais recente é sorteio, porque ele quase sempre mostra uma requisição normal que não ensina nada sobre o problema.
Comece pelo sintoma, porque ele define a ordenação e o filtro. Para lentidão, ordene por Mais lentos e filtre pelo serviço ou pela operação que o alerta citou. Para falha, troque o resultado para Com erro. O filtro de duração mínima e máxima corta a lista para a faixa que interessa, como tudo o que passou do p95.
Pelo painel de facetas, dá para filtrar por atributo: service.name, status.code, error.type e os grupos http.* e messaging.*, entre outros. Quando o ponto de partida é um log, a própria linha leva ao trace dela. Quando é um teste sintético que falhou, o cartão de falha abre o trace da execução.
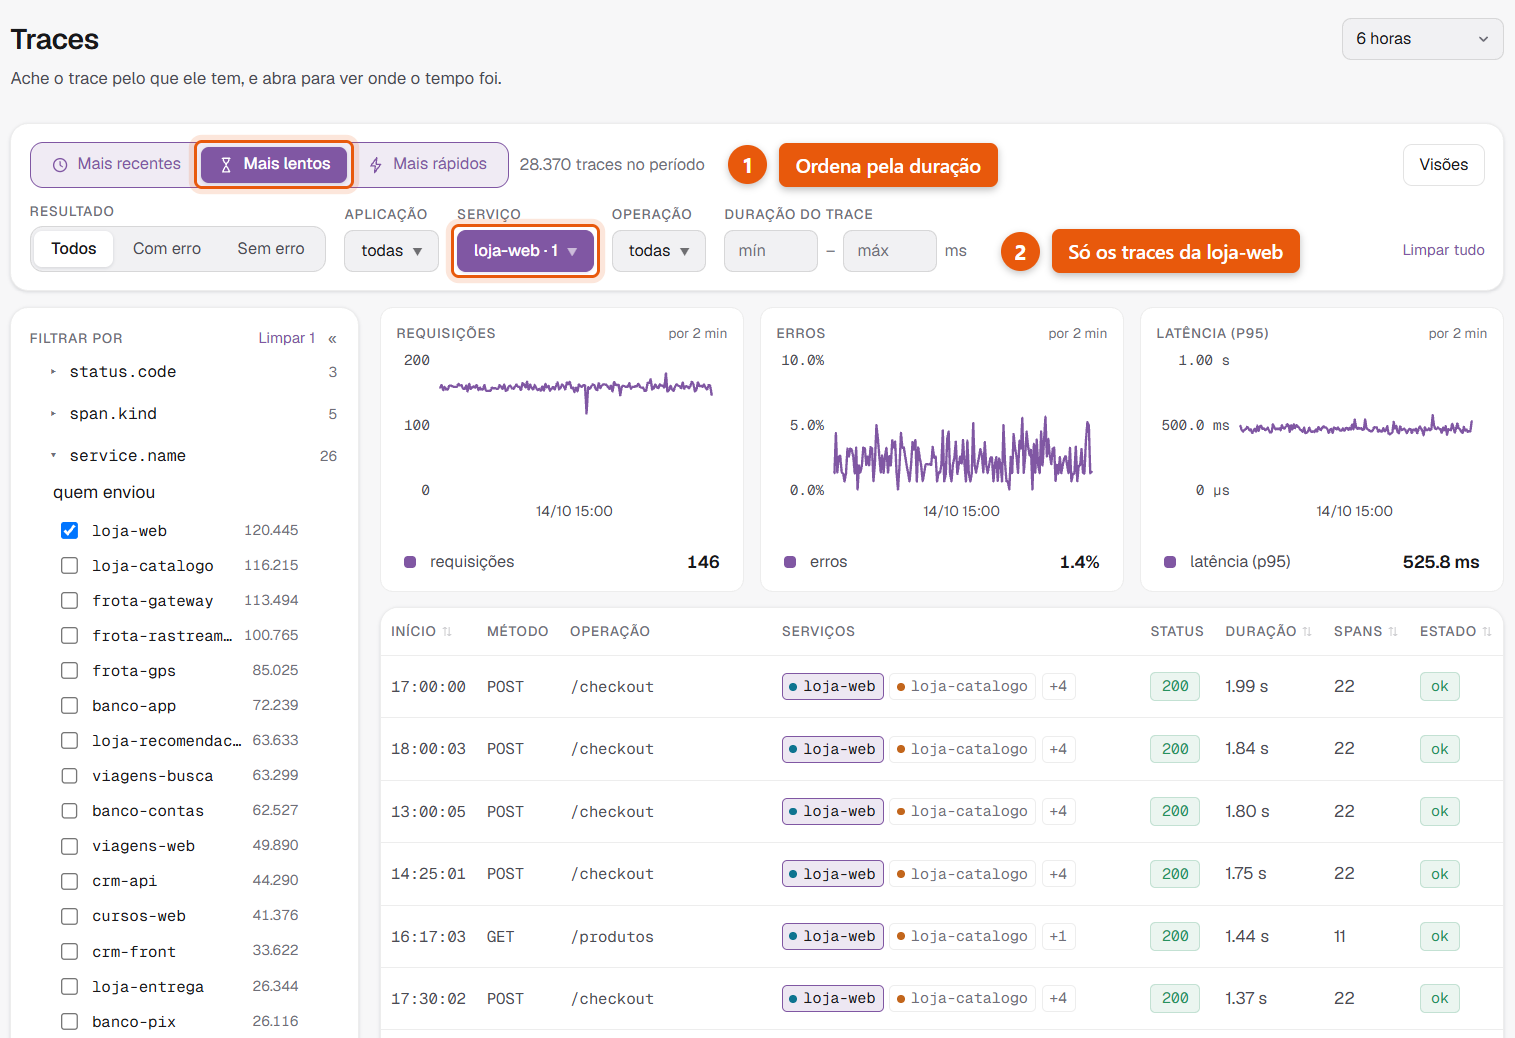
Na lista do laboratório, o p95 da loja-web no período ficou em 525,8 ms, enquanto os quatro checkouts do topo passaram de 1,7 s. Três deles começaram logo na virada da hora: 17:00:00, 18:00:03 e 13:00:05. Coincidência de horário assim pede cruzamento com o agendamento de jobs antes de virar conclusão.
Esta é a lista de traces do laboratório ordenada por Mais lentos e filtrada pelo serviço loja-web:
Passo 2: leia a cascata de cima para baixo
Na cascata (waterfall), cada span vira uma barra. A primeira linha é a raiz, que representa a requisição inteira do ponto de vista de quem a recebeu. O recuo mostra quem chamou quem, enquanto a largura da barra é a duração e a posição horizontal marca quando o span começou.
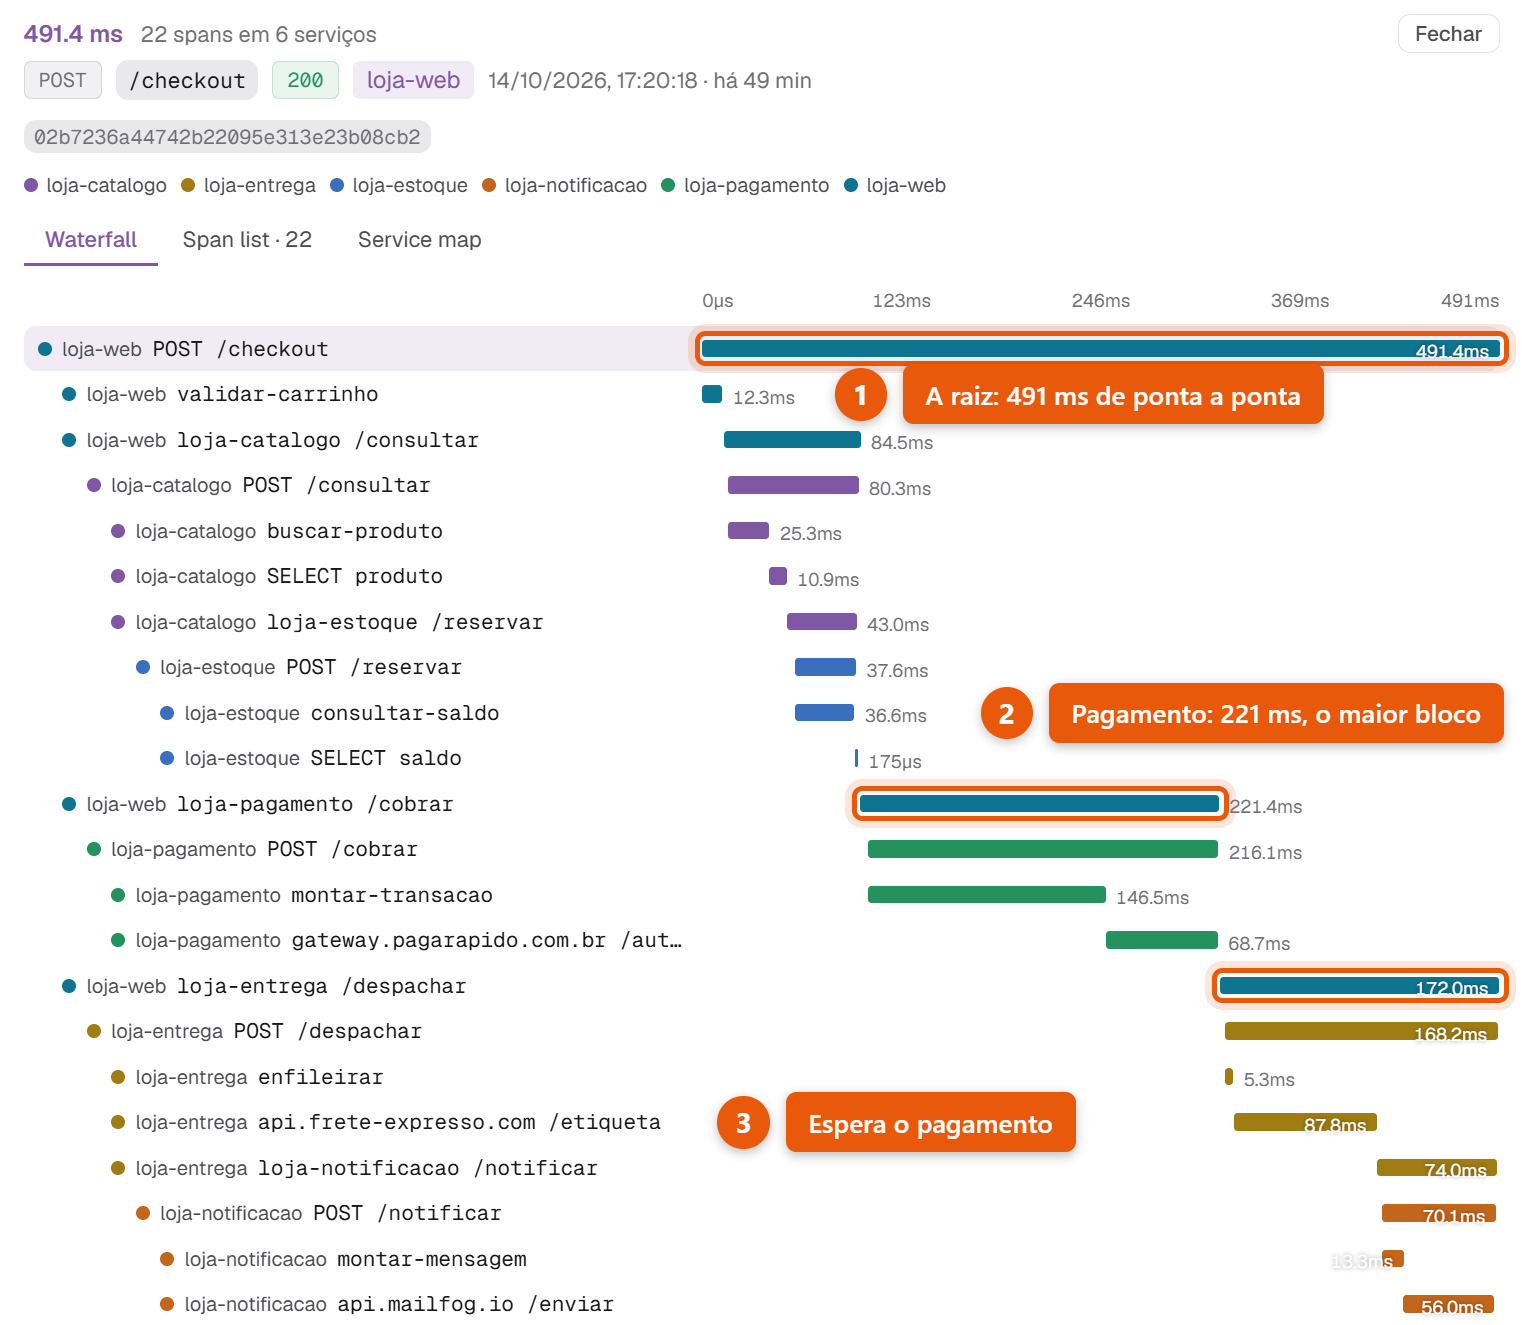
Neste exemplo, o POST /checkout levou 491,4 ms, com 22 spans em seis serviços. Depois de validar o carrinho em 12,3 ms, o loja-web chama o catálogo (84,5 ms), o pagamento (221,4 ms) e a entrega (172,0 ms). As barras formam uma escada, já que cada chamada só começa quando a anterior termina.
A escada indica sequência; barras sobrepostas indicam paralelismo. Nesse checkout, catálogo, pagamento e entrega somam 477,9 ms dos 491,4 ms da raiz. Se a ordem não for obrigatória, rodar as chamadas em paralelo encurta o total. Quando ela é regra de negócio, como não despachar pedido sem cobrança aprovada, o tempo total é a soma dos degraus. Nesse caso, só resta encurtar um deles.
Na cascata do checkout de 491,4 ms, os três degraus da escada aparecem um depois do outro:
Tempo do span pai e tempo dos filhos
Uma barra larga no span pai não significa que ele gastou esse tempo sozinho, porque a barra inclui o tempo dos filhos. No pagamento, o próprio serviço levou 216,1 ms para atender o POST /cobrar. Os 221,4 ms medidos pelo loja-web incluem também a ida e a volta pela rede, diferença que o passo 3 explica.
Dentro desses 216,1 ms, a operação interna montar-transacao levou 146,5 ms e a chamada ao gateway de pagamento levou 68,7 ms. Nesse trace, o suspeito do pagamento é o código do próprio serviço, não o terceiro.
A pergunta útil, portanto, é qual filho preenche a barra do pai. Quando nenhum filho a preenche, sobra uma lacuna entre as barras. Esse vazio é tempo gasto em código sem instrumentação, em fila ou em rede.
Passo 3: compare com um trace lento da mesma operação
Sozinho, um trace não diz se 221 ms de pagamento é muito. A comparação diz: outro checkout, às 17:00 do mesmo dia, levou 1,99 s com os mesmos 22 spans. A aba Span list põe esses spans numa tabela ordenada pela duração, com o tipo e o instante de início de cada um.
O tipo de cada span é o SpanKind descrito na documentação de conceitos do OpenTelemetry. Uma chamada entre serviços aparece duas vezes: como Client no serviço que chamou e como Server no serviço que atendeu.
A diferença entre os dois é o tempo que a requisição passou fora do servidor. Quando ela é grande, o tempo se perdeu no caminho, não no código do serviço chamado.
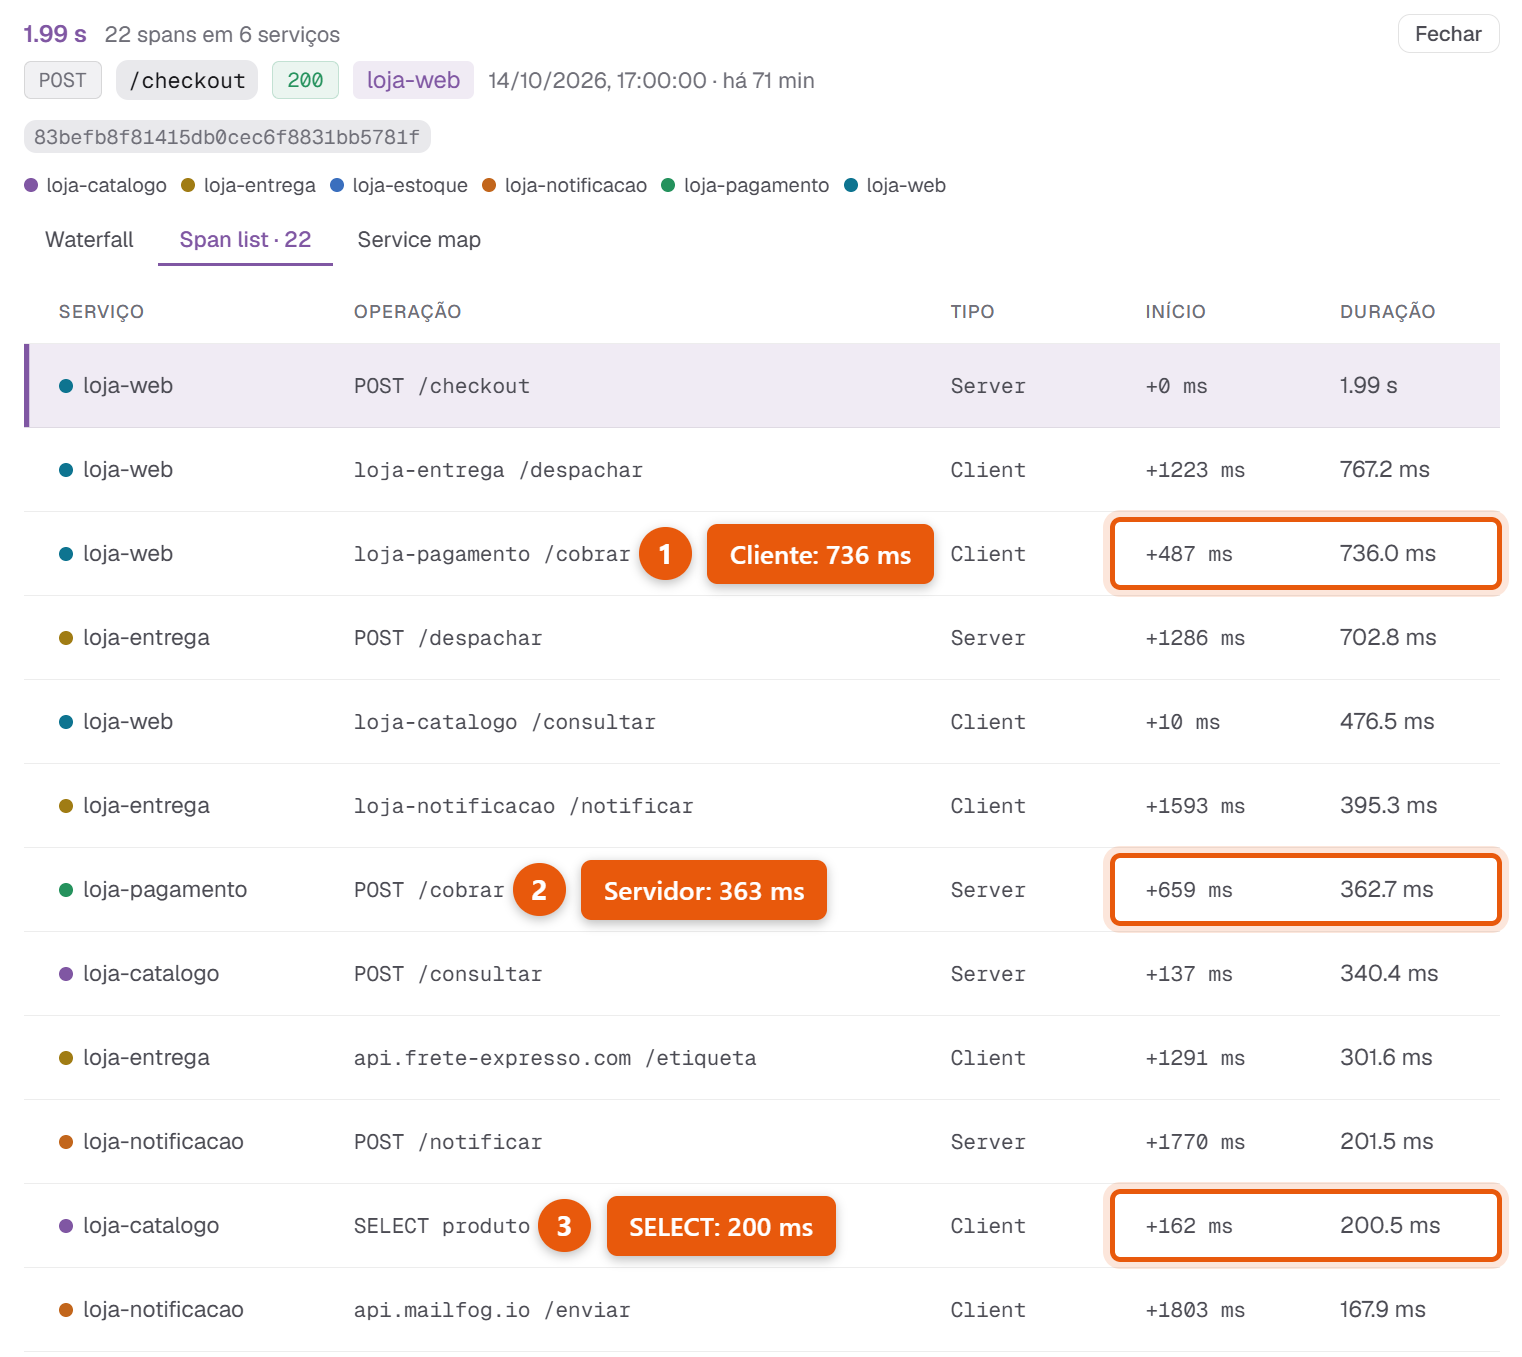
No trace lento, o loja-web esperou 736,0 ms pelo pagamento, que trabalhou 362,7 ms. Os outros 373 ms ficaram antes de a requisição chegar e depois de a resposta sair. Nesse intervalo cabem rede, fila, pool de conexões esgotado ou o próprio chamador ocupado. No catálogo, o servidor só começou 127 ms depois da chamada.
Quando esse intervalo cresce em vários serviços ao mesmo tempo, a suspeita recai sobre um recurso compartilhado saturado, não sobre um bug de código. O mesmo trace traz outro desvio que merece o passo seguinte: o SELECT produto, que levava 10,9 ms no checkout normal, levou 200,5 ms.
Na aba Span list do checkout de 1,99 s, os spans Client e Server do pagamento aparecem com o início e a duração de cada um:
Já a aba Service map desenha o mesmo trace como grafo, com o tempo do serviço chamado em cada seta. O banco aparece sob o serviço que o consultou; os terceiros ficam em caixas tracejadas, marcados como externos.
Passo 4: abra a consulta SQL do span de banco
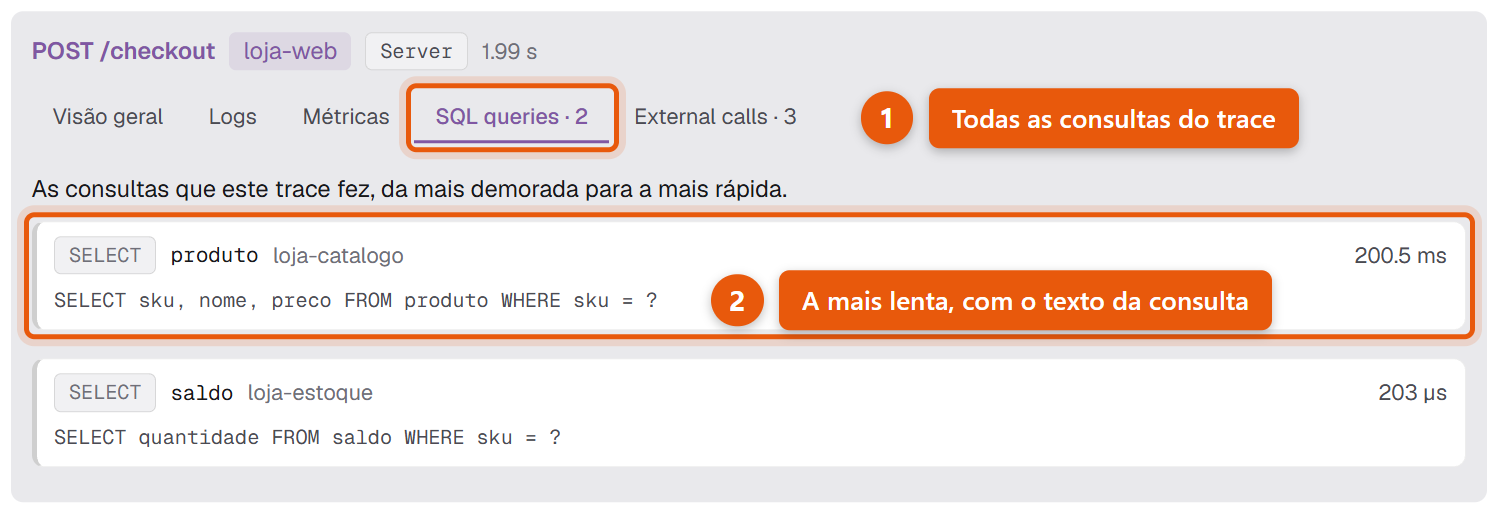
Span de banco é um span Client que guarda o texto da consulta executada. Na aba SQL queries, o KeepWatch lista as consultas do trace, da mais demorada para a mais rápida.
A consulta aparece parametrizada: SELECT sku, nome, preco FROM produto WHERE sku = ?. É o que pedem as convenções do OpenTelemetry para o atributo db.query.text: o valor dos parâmetros só é gravado quando alguém habilita essa coleta. Por isso o SKU que o cliente comprou não fica guardado no backend de traces.
Essa mesma consulta levou 10,9 ms no checkout normal e 200,5 ms no lento, 18 vezes mais. Quando o texto não muda e o tempo muda, a pergunta passa do código para o banco naquele minuto: bloqueio, I/O ou concorrência. O próximo lugar a olhar são as métricas do banco de dados no mesmo horário.
Nessa aba também aparece, quando existe, o problema N+1: o mesmo SELECT repetido dezenas de vezes em escada, um para cada item da lista. Nesse caso o remédio fica no código que monta a consulta, não no índice da tabela.
Na aba SQL queries do checkout lento, o SELECT produto aparece no topo:
Foi a captura da consulta exata que destravou o diagnóstico no Instituto Butantan. O SESuite, plataforma de gestão de documentos, chegava a levar de 3 a 5 minutos por operação. A resposta habitual era reiniciar o serviço ou aumentar o hardware.
Com traces OpenTelemetry e a query exata do SQL Server, chegamos à causa: consulta lenta e consumo excessivo de memória pelo Java. O ajuste no banco e na aplicação reduziu a lentidão sem hardware novo, como mostra o case do Instituto Butantan.
Para ouvir o lado do cliente, no OpCast #06 Claudia Anania, CIO do Instituto Butantan, conta como a TI sustentou a produção de vacinas.
Passo 5: siga o erro até o span mais fundo
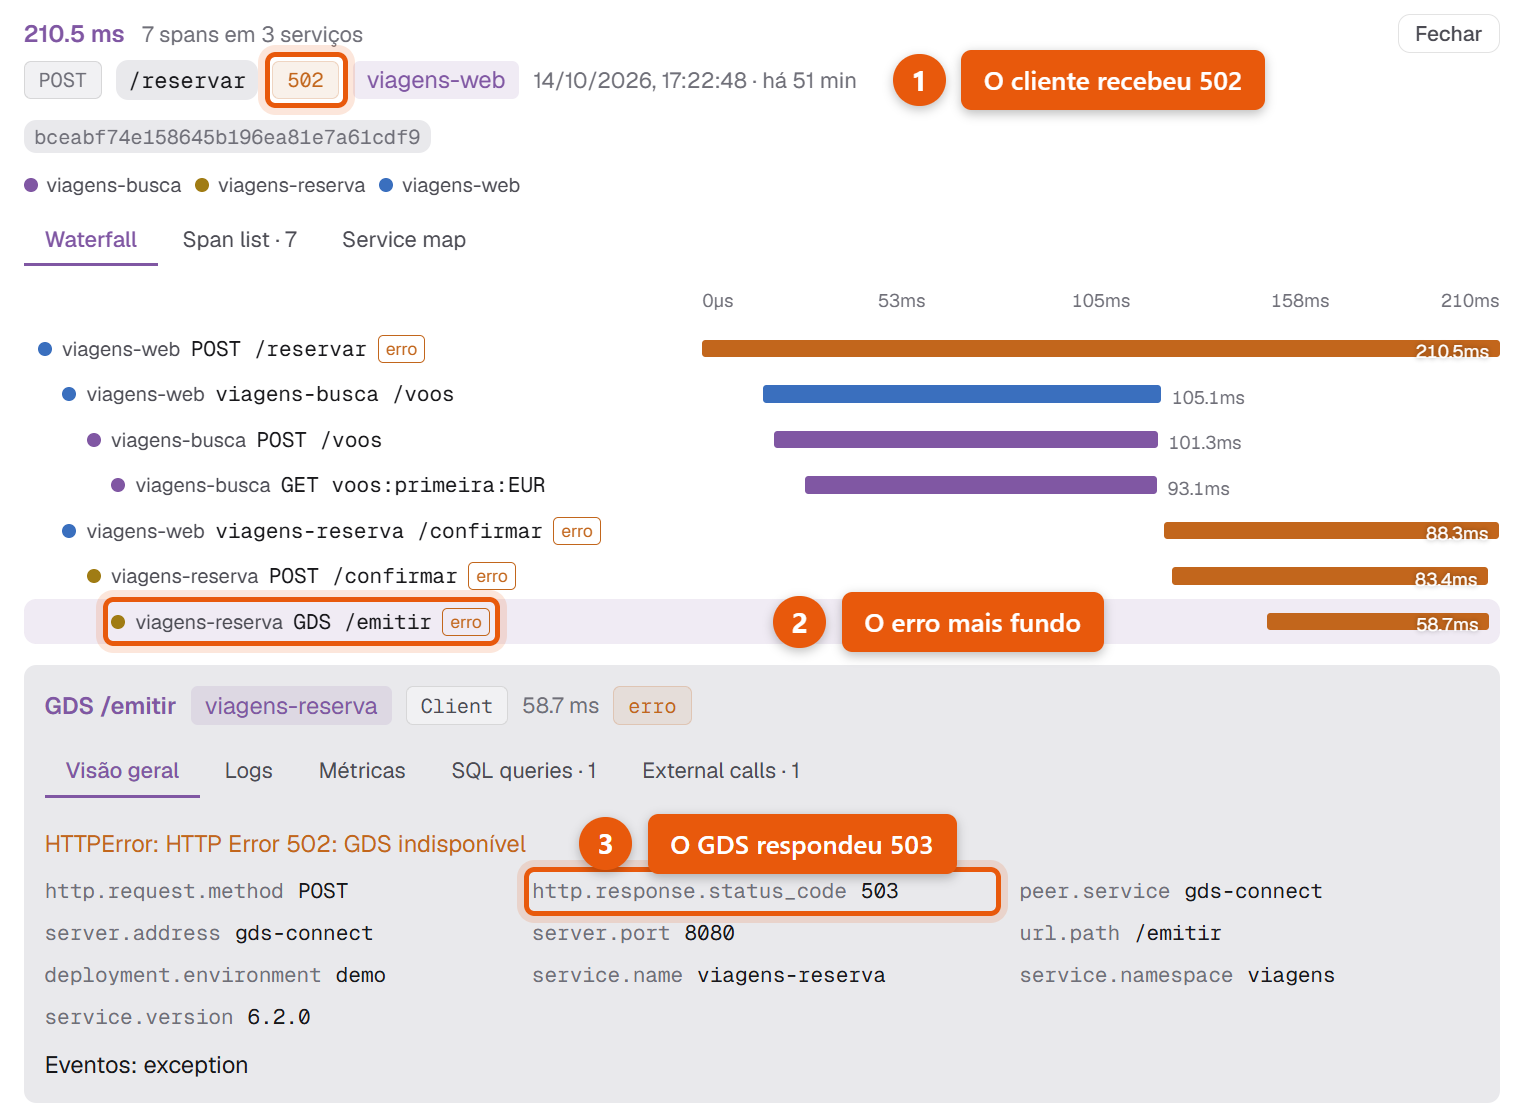
O erro sobe pela cascata, do span que falhou até a raiz. No POST /reservar do laboratório, quatro dos sete spans carregam a marca de erro. A marca vai da raiz até a chamada GDS /emitir, que o serviço viagens-reserva faz ao GDS. O GDS é o sistema de reservas que as agências usam para emitir passagens.
A causa está no span com erro mais fundo, porque os de cima só repassaram a falha.
Abra esse span e leia os atributos antes da mensagem. O atributo é preenchido pela instrumentação a cada chamada, enquanto a mensagem é texto livre escrito por quem programou o serviço.
Nos atributos, http.response.status_code mostra que o GDS respondeu 503, enquanto o viagens-web devolveu 502 ao cliente. O código de status muda no caminho: o 502 que o cliente viu é o sintoma, enquanto a causa está no 503 do terceiro.
A mensagem da exceção registrada no span diz HTTP Error 502: GDS indisponível, enquanto o atributo mostra 503. Quando os dois discordam, quem decide é o log do serviço, que é o assunto do passo seguinte.
O filtro Com erro lê o status do span, não o código HTTP. No OpenTelemetry, um span concluído sem falha fica com status Unset, a falha vira Error e Ok só aparece quando o desenvolvedor marca de propósito.
Por isso o filtro também traz requisições que deram certo para o cliente. No laboratório, uma busca de voos devolveu 200 mesmo com o span do cache Redis em erro, porque a resposta veio direto do GDS.
No trace da reserva, a marca de erro vai da raiz até o GDS /emitir, aberto com os atributos:
Passo 6: confirme no log do span que falhou
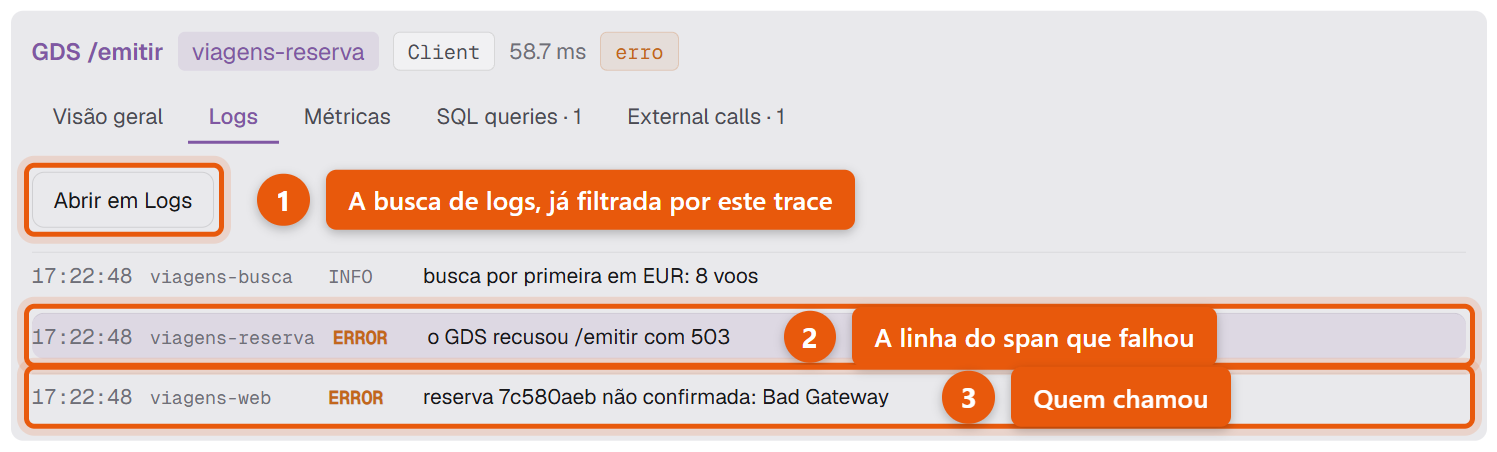
Na aba Logs do span ficam as linhas que os serviços gravaram durante aquele trace, com a linha do próprio span destacada.
Na reserva, o viagens-reserva registrou o GDS recusou /emitir com 503 e o viagens-web registrou reserva 7c580aeb não confirmada: Bad Gateway. O log confirma, portanto, que o 503 do atributo estava certo.
Essa ligação depende de o log carregar o contexto do trace. O modelo de dados de log do OpenTelemetry reserva os campos TraceId e SpanId para isso. Aplicação que grava log sem eles produz linhas que nenhuma ferramenta consegue amarrar ao trace.
A convenção atual do OpenTelemetry manda registrar a exceção no log. Gravá-la como evento do span aparece como obsoleto na especificação de exceções em spans, embora ainda seja o padrão. Foi o que o laboratório fez no passo 5.
Na prática, o motivo detalhado do erro fica no log, enquanto o trace diz onde e quando procurá-lo.
Para ver o contexto em volta ou linhas de outros níveis, o botão Abrir em Logs leva à busca já filtrada pelo trace. Trace e log respondem perguntas diferentes, como detalha o guia de logs na observabilidade: o trace mostra onde e quanto, o log mostra o porquê.
Na aba Logs do span GDS /emitir, as duas linhas de erro aparecem logo abaixo do botão Abrir em Logs:
Ebook: Como sobreviver à fatura cloud?
Nosso framework, Observability Maturity Index, mede a maturidade das operações em nuvem das empresas. Você encontrará: os quatro perfis de empresas, as métricas que você deveria estar medindo, um checklist de avaliação e um plano de ação para 90 dias.
Só o e-mail. Sem spam, e seus dados protegidos pela LGPD.
Quando o trace mostra menos do que aconteceu
Três situações fazem a cascata contar uma história incompleta sem dar nenhum aviso na tela.
Trace partido. Um serviço que não repassa o traceparent, como um proxy mal configurado ou um consumidor de fila sem instrumentação, começa um trace novo. A cascata termina num span sem filho; a continuação aparece como outro trace, com outro trace_id.
Terceiro sem instrumentação. Gateway de pagamento, API de frete e serviço de e-mail aparecem como chamadas externas. A aba External calls do KeepWatch avisa que, nesses casos, o que se mede é o lado de cá. Ou seja, o tempo que o chamador esperou, com a rede incluída.
Amostragem na origem. Nesse modelo (head sampling), a decisão de guardar o trace é tomada no começo da requisição, quando ninguém sabe se ela vai ser lenta. Como o descarte é aleatório, o trace raro, que é o que interessa, some tanto quanto os normais. Já a amostragem na cauda (tail sampling) decide no fim e guarda todo trace com erro ou acima de um limiar de duração.
Logs, métricas e traces unificados para diagnóstico em profundidade.
Instrumentamos aplicações corporativas com OpenTelemetry para correlacionar eventos e acelerar a análise de causa raiz em produção.
Por onde começar a ler traces no seu ambiente
Escolha uma operação que o negócio sente, como checkout, emissão de boleto ou reserva. Abra dez traces dela: cinco normais e cinco entre os mais lentos. A comparação entre os dois grupos ensina mais que qualquer trace isolado, porque mostra qual degrau da escada cresce quando a operação piora.
Antes disso, confira três pré-requisitos. Todos os serviços do caminho precisam propagar o traceparent, senão o trace sai partido. O log tem de gravar o trace_id e o span_id, senão o passo 6 não existe. A amostragem precisa guardar erro e lentidão, senão o trace que interessa nunca chega à tela.
Resolvidos esses três pontos, a investigação deixa de depender de quem conhece o sistema de cabeça. O caminho do sintoma até a linha de log passa a ficar registrado em cada requisição. Para instrumentar suas aplicações e ler os traces delas no KeepWatch, fale com um especialista da OpServices.