A aplicação sobe em dois containers, cada um querendo escutar a porta 443, que o sistema operacional entrega ao primeiro que chegou. Duas semanas depois entra um terceiro serviço, depois um subdomínio novo, depois um certificado que precisa ser renovado em quatro lugares diferentes. Nesse ponto alguém sugere um proxy reverso na frente de tudo. […]
Healthcheck e heartbeat: como escolher o sinal de vida certo para cada componente
Um dashboard inteiramente verde não prova que o sistema funciona. Ele prova apenas que alguma verificação respondeu. Quando essa verificação pergunta a coisa errada, a equipe descobre a falha pelo telefone do cliente, nunca pelo alerta. Healthcheck e heartbeat são os dois mecanismos que sustentam essa verificação. Ambos respondem à pergunta “isso ainda está vivo?”, […]
Mainframes: o que são, como funcionam e por que dominam
Em 2026, 67 das 100 maiores empresas do mundo ainda rodam suas cargas mais críticas em mainframes. Bancos brasileiros processam PIX, débito automático e folha de pagamento em sistemas IBM Z que cabem em um único gabinete refrigerado. No entanto, fora desses datacenters blindados, o tema vive cercado de mitos: muita gente acredita que o […]
Cluster de virtualização: o que é, componentes e operação
Quando um único host de virtualização falha, dezenas de máquinas virtuais saem do ar ao mesmo tempo. O impacto cresce de forma desproporcional em ambientes consolidados, em que cada servidor físico hospeda cargas críticas de áreas distintas. Por isso, o cluster de virtualização deixou de ser um diferencial e virou requisito básico para infraestrutura corporativa […]
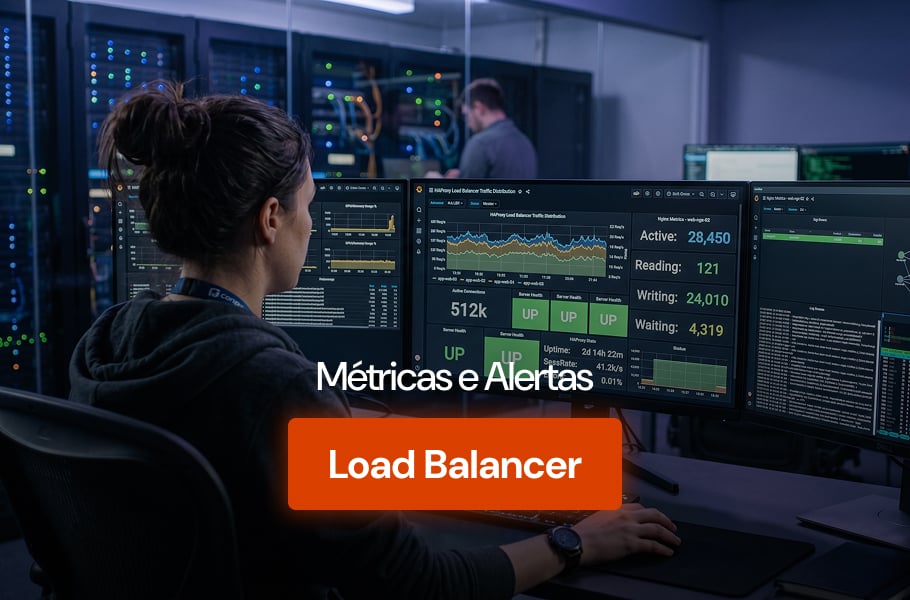
Monitoramento de load balancer: métricas e alertas
Para a maioria das aplicações corporativas modernas, o load balancer é a primeira parada do tráfego. Ele também é o primeiro ponto onde uma degradação pode se esconder por dias sem que ninguém perceba. Por ser visto como infraestrutura que simplesmente funciona, costuma ficar fora do radar do time de operações até o momento em […]
Failover automático: as 4 etapas da comutação, 7 modos de falha e o failback
O health check falhou três vezes seguidas. Em seguida, o cluster promove o nó de reserva, o balanceador tira o antigo primário do pool e o serviço volta a responder. Num laboratório com dois nós, a troca do endereço virtual levou 3,3 segundos. A pergunta que interessa depois disso não é o significado da palavra. […]
Servidor dedicado: o que é, quando compensa e como comparar com VPS e nuvem
Escolher entre um servidor dedicado, um VPS e uma instância de nuvem parece uma decisão técnica. Na prática, é uma decisão sobre risco e sobre custo. O hardware muda pouco de um modelo para o outro. O que muda é quem divide a máquina com você e quem responde quando ela para. Quem pesquisa o […]