Uma GPU de datacenter custa o mesmo parada ou em carga total, ainda que só a segunda condição gere retorno. A Cast AI mediu dezenas de milhares de clusters na AWS, no Azure e no GCP. Entre 2025 e abril de 2026, a utilização média ficou em 5%. O gargalo quase nunca é a placa, […]
Erros de pod no Kubernetes: CrashLoopBackOff, OOMKilled, ImagePullBackOff e 7 outros
São 3h da manhã. O kubectl get pods devolve a mesma linha há vinte minutos: CrashLoopBackOff, 47 restarts, nenhuma pista na tela. O pipeline passou. O deploy foi aplicado. O cluster continua de pé. O status daquela coluna nomeia o sintoma, nunca a causa. Dois pods em CrashLoopBackOff podem quebrar por motivos sem nenhuma relação […]
Healthcheck e heartbeat: como escolher o sinal de vida certo para cada componente
Um dashboard inteiramente verde não prova que o sistema funciona. Ele prova apenas que alguma verificação respondeu. Quando essa verificação pergunta a coisa errada, a equipe descobre a falha pelo telefone do cliente, nunca pelo alerta. Healthcheck e heartbeat são os dois mecanismos que sustentam essa verificação. Ambos respondem à pergunta “isso ainda está vivo?”, […]
Como implementar OpenTelemetry no Kubernetes: do Collector ao Operator
Rodar aplicações em Kubernetes multiplica os dados que a operação precisa coletar: métricas de pods, logs de containers, eventos do cluster e traces distribuídos. Sem um padrão único de coleta, cada equipe instala um agente diferente. Como resultado, os custos crescem e a visibilidade fica fragmentada. O OpenTelemetry surgiu para resolver esse problema com um […]
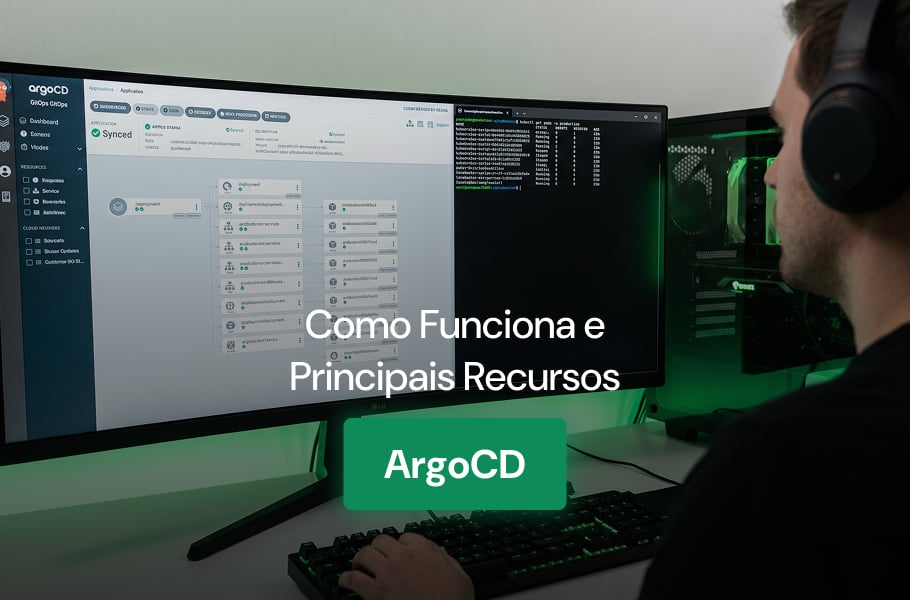
ArgoCD: o que é, como funciona e principais recursos
Toda equipe que opera clusters Kubernetes em produção mais cedo ou mais tarde esbarra na mesma pergunta: como garantir que o estado real do cluster reflita exatamente o que está no repositório Git? O ArgoCD resolve esse problema de forma padronizada e auditável. Em 2026, o ArgoCD é o controlador de CD GitOps mais adotado […]
Segurança de Containers: Quais são as principais ameaças, ferramentas e boas práticas?
A adoção de containers redefiniu a velocidade de entrega de software nas empresas brasileiras. No entanto, ela trouxe uma nova superfície de ataque que ferramentas tradicionais de segurança não cobrem. Por isso, a Segurança de Containers virou uma disciplina obrigatória para equipes de DevOps, SRE e AppSec. Em ambientes modernos, um container pode subir, processar […]
Blue-green Deployment: o que é e como implementar sem risco
Entregar novas versões de software sem derrubar a aplicação deixou de ser diferencial e virou requisito. Equipes de engenharia precisam implantar mudanças várias vezes por dia, reduzir o risco de cada liberação e garantir que um rollback seja questão de segundos. É nesse cenário que o blue-green deployment ganhou espaço como uma das estratégias mais […]
Service Mesh: o que é, como funciona e quando adotar
Quando uma aplicação evolui de dois ou três microsserviços para algumas dezenas, a comunicação entre eles deixa de ser detalhe de arquitetura e vira o maior foco de problemas em produção. Retries, timeouts, mTLS, descoberta de serviços e coleta de métricas passam a ser implementados em cada repositório, em cada linguagem, de forma levemente diferente. […]
Canary deployment: o que é, como funciona e boas práticas
Todo time de engenharia que já viu um deploy derrubar uma funcionalidade crítica em produção sabe que empurrar uma nova versão direto para 100% dos usuários é um risco desnecessário. A cada release, existe a chance de uma regressão escorregar pelos testes automatizados, de uma mudança de configuração provocar efeitos colaterais inesperados ou de um […]
Cloud computing: o guia completo em 2026 para empresas
Em 2026, praticamente nenhuma área de TI escapa do impacto do cloud computing. De startups com arquitetura 100% serverless a bancos tradicionais migrando cargas críticas para ambientes híbridos, a nuvem deixou de ser um diferencial para se tornar a infraestrutura padrão de qualquer operação digital relevante. O problema é que o tema amadureceu muito além […]