Escolher o backend de logs certo define quanto sua equipe gasta por mês. Também determina quanto tempo leva para achar um erro em produção e quanto trabalho operacional sobra no fim do mês. Nesse cenário, duas ferramentas dominam a conversa: Grafana Loki e Elasticsearch. Elasticsearch nasceu como motor de busca distribuído e virou o padrão […]
Tomcat: o que é, como funciona e como monitorar
O Apache Tomcat é um dos servidores de aplicação Java mais usados no mundo corporativo. Ele sustenta desde APIs internas até sistemas de missão crítica que não podem ficar fora do ar. Ainda assim, muita equipe só descobre como ele funciona quando a aplicação trava em produção. Entender o que é o Tomcat é apenas […]
PromQL na prática: guia de queries para Prometheus
Se você já olhou para uma query de PromQL aninhando agregações e funções de histograma e teve a sensação de estar lendo grego, este guia é para você. PromQL é a linguagem que transforma o Prometheus de um coletor de métricas em um motor de observabilidade capaz de responder perguntas de negócio em segundos. O […]
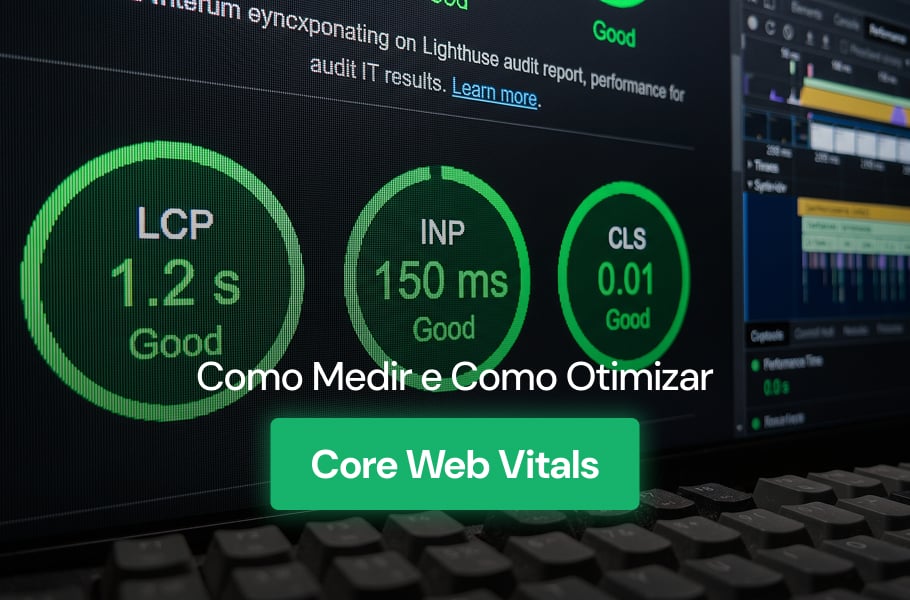
Core Web Vitals: O que são, como medir e como otimizar?
Quando um usuário abre uma aplicação web, três coisas determinam se ele fica ou desiste antes mesmo de interagir. A imagem principal demora para aparecer, um botão leva quase meio segundo para responder ao clique ou o layout se reorganiza no meio da leitura. Esses três sinais foram transformados pelo Google em métricas padronizadas chamadas […]
Jaeger: o que é, como funciona e como usar na prática
Quando uma requisição atravessa dezenas de microsserviços antes de retornar uma resposta ao usuário, identificar onde ocorre um gargalo de latência se torna um desafio real. É nesse cenário que entra o Jaeger, uma plataforma open source de rastreamento distribuído criada para dar visibilidade ao caminho completo de cada transação. Neste artigo, você vai entender […]
APDEX Score: o que é, fórmula e como interpretar
Todo time de TI já tomou decisão baseada em tempo médio de resposta. O problema é que a média esconde quase tudo que importa: o usuário que esperou oito segundos, a página que travou em horário de pico e a API que virou um pesadelo só para 5% dos clientes. O APDEX Score nasceu exatamente […]
Principais KPIs de Observabilidade: Exemplos e Guia Completo
Times de tecnologia investem alto em observabilidade, mas, na prática, muita gente olha para uma enxurrada de gráficos sem saber qual número importa. Sobram dashboards e faltam decisões. O problema raramente é a ferramenta. Em geral, falta uma lista clara de KPIs ancorados em frameworks consagrados e amarrados ao negócio. Este guia consolida os principais […]
Monitoramento sintético vs RUM: Quando usar cada um?
Toda equipe de operações chega, em algum momento, à mesma pergunta: vale mais investir em monitoramento sintético ou em RUM? A dúvida costuma surgir quando o time percebe que o dashboard de infraestrutura diz que está tudo verde, mas o cliente segue reclamando de lentidão. Ou o contrário: a aplicação caiu às três da manhã […]
Profiling de Aplicações: Guia Técnico Completo
Quando um serviço fica lento, a primeira pergunta que toda equipe de engenharia faz é a mesma: por quê? Métricas mostram que a latência subiu. Logs indicam em qual endpoint. Traces mapeiam a jornada da requisição pelos microsserviços. Mas nenhum desses sinais diz qual linha de código está consumindo CPU, alocando memória em excesso ou […]
LCP (Largest Contentful Paint): O que é e como otimizar?
Quando um usuário abre uma página, ele não conta milissegundos até a primeira pintura no navegador. Ele espera ver alguma coisa real, útil, antes de decidir se fica ou volta. É exatamente esse momento que o LCP (Largest Contentful Paint) tenta medir. O LCP é uma das três Core Web Vitals que o Google usa […]