OpenTelemetry vs Prometheus: Principais diferenças e integração
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
Se você está desenhando uma estratégia de observabilidade em 2026, provavelmente já esbarrou no debate OpenTelemetry vs Prometheus e ficou na dúvida sobre qual escolher. A boa notícia, no entanto, é que essa pergunta está mal formulada na maioria dos cenários.
OpenTelemetry e Prometheus não são concorrentes diretos. Um é um padrão aberto de instrumentação e coleta de dados de telemetria. O outro, em contrapartida, é um backend especializado em métricas. Eles ocupam camadas diferentes do stack e, na arquitetura mais adotada hoje, trabalham juntos.
Este guia apresenta as diferenças entre as duas ferramentas e explica quando adotar cada uma isoladamente. Além disso, mostra como combiná-las com o Prometheus 3.x atuando como backend OTLP nativo.
Para as armadilhas, porém, recomendação genérica não basta. Por isso montamos a integração em laboratório e medimos o custo de cada decisão. Os números aparecem ao longo do texto, junto com o docker-compose que os gerou.
O que é OpenTelemetry e qual problema ele resolve?
OpenTelemetry, ou simplesmente OTel, é um projeto open source da Cloud Native Computing Foundation. Ele define APIs, SDKs e um protocolo de exportação padronizados para dados de telemetria.
O problema que o OTel resolve é o vendor lock-in. Antes dele, cada ferramenta de observabilidade trazia seu próprio agente e formato proprietário. Como resultado, trocar de backend significava reinstrumentar aplicações inteiras. Com OTel, por outro lado, a instrumentação acontece uma vez só, no padrão OTLP. Depois disso, a aplicação exporta os dados para qualquer backend compatível.
O escopo do OpenTelemetry cobre os três sinais principais da observabilidade (métricas, logs e traces) com especificação unificada. Além disso, o projeto entrega o OpenTelemetry Collector, um binário que funciona como proxy de coleta. Ele recebe, processa e exporta dados para múltiplos destinos ao mesmo tempo.
Para entender a base conceitual dos três sinais, vale revisar os três pilares da observabilidade.
Por padrão, OTel não é backend. Ele não armazena dados nem oferece interface de consulta. Essa é, portanto, uma decisão arquitetural intencional, para manter o projeto neutro em relação ao fornecedor.
O que é Prometheus e qual problema ele resolve?
Prometheus é um sistema de monitoramento e banco de dados de séries temporais (TSDB), também graduado pela CNCF. Nasceu no SoundCloud em 2012, inspirado no Borgmon do Google. Depois disso, virou o padrão de fato para métricas em ambientes cloud-native.
O problema que o Prometheus resolve é a coleta, armazenamento e consulta eficiente de métricas numéricas. Ele combina três elementos em um único componente. São eles: um scraper que coleta métricas via HTTP, um TSDB otimizado para alta cardinalidade temporal e a linguagem PromQL. Com ela, o time faz agregações, alertas e análises em tempo real.
A arquitetura do Prometheus é pull-based: o servidor descobre alvos (targets) via service discovery e faz requisições HTTP para o endpoint /metrics em intervalos regulares. Dessa forma, o modelo simplifica a operação em ambientes Kubernetes, onde pods aparecem e desaparecem dinamicamente.
O foco do Prometheus é exclusivamente métricas. Ele não lida com logs ou traces. Essa é uma escolha deliberada: o projeto prefere fazer uma coisa bem feita a tentar ser uma plataforma de observabilidade inteira. Nosso guia sobre Prometheus e PromQL na prática aprofunda essa arquitetura.
OpenTelemetry vs Prometheus: tabela comparativa direta
A tabela abaixo resume as diferenças estruturais que mais impactam a decisão de arquitetura.
| Dimensão | OpenTelemetry | Prometheus |
|---|---|---|
| Categoria | Padrão de instrumentação e coleta | Backend de métricas com TSDB |
| Sinais suportados | Métricas, logs, traces | Apenas métricas |
| Modelo de coleta | Push e pull (flexível) | Pull (scraping de targets) |
| Armazenamento | Não possui (requer backend externo) | TSDB nativo local |
| Linguagem de consulta | Depende do backend | PromQL |
| Alertas | Não possui nativamente | Alertmanager integrado |
| Protocolo | OTLP (gRPC/HTTP) |
Exposition format sobre HTTP |
| Formato de métricas | Delta e cumulativo | Apenas cumulativo |
| Maturidade (2026) | Traces, métricas e logs em GA | Versão 3.x madura |
A leitura correta dessa tabela é que as ferramentas vivem em camadas diferentes. OTel cuida do como gerar e transportar dados. Prometheus, em contrapartida, cuida do onde guardar e consultar métricas.
Diferenças fundamentais explicadas
Quatro diferenças merecem atenção especial porque aparecem toda semana em decisões de arquitetura.
Escopo: três sinais vs métricas puras
OpenTelemetry é um framework de observabilidade completo. Prometheus é um sistema de métricas. Imagine correlacionar uma queda de latência (métrica) com uma exceção específica no código (trace), mais o log estruturado que acompanha o erro. Nesse caso, o Prometheus sozinho não entrega. OTel entrega.
Na camada de métrica, no entanto, os dois se encontram. O guia de métricas de OpenTelemetry mostra, inclusive, os instrumentos do OTel em código e como cada um chega no Prometheus.
Coleta: pull vs push (e híbrido)
O modelo pull do Prometheus funciona muito bem quando os alvos têm endereços estáveis e podem expor métricas via HTTP. Kubernetes, por exemplo, cai como uma luva nesse padrão. Já workloads efêmeras, serverless e batch jobs combinam melhor com push. É aí que o OTel entra, porque o Collector aceita tanto push (via OTLP) quanto pull.
Armazenamento: acoplado vs desacoplado
O Prometheus traz seu próprio TSDB local, o que torna a stack mais simples para times pequenos. Em contrapartida, escalar além de um nó exige ferramentas complementares como Thanos ou Cortex. OTel não armazena nada: você escolhe o backend (Prometheus, Mimir, Jaeger, backends comerciais), o que dá flexibilidade mas adiciona uma decisão a mais.
Vendor neutrality
OpenTelemetry foi desenhado para eliminar o vendor lock-in. Ou seja, instrumentar com OTel faz a troca de backend caber numa reconfiguração do exporter, sem tocar no código da aplicação. Prometheus é neutro quanto a fornecedores de dashboards e alertas, mas o formato de exposition e o PromQL criam uma dependência forte no ecossistema Prometheus.
Ebook: Como sobreviver à fatura cloud?
Nosso framework, Observability Maturity Index, mede a maturidade das operações em nuvem das empresas. Você encontrará: os quatro perfis de empresas, as métricas que você deveria estar medindo, um checklist de avaliação e um plano de ação para 90 dias.
Só o e-mail. Sem spam, e seus dados protegidos pela LGPD.
Quando usar Prometheus?
Prometheus continua sendo a escolha mais pragmática em diversos cenários. Considere usá-lo isoladamente quando:
➡️ O seu ambiente é Kubernetes-first e você precisa de métricas operacionais rápidas, com alertas baseados em PromQL e integração nativa com o kube-state-metrics. Além disso, a combinação Prometheus + Grafana continua imbatível em custo-benefício para monitoramento de infraestrutura.
➡️ O foco é monitoramento de infraestrutura e serviços backend: métricas de CPU, memória, latência de endpoints, taxa de erros HTTP. Traces e logs detalhados, portanto, não são o gargalo do time.
➡️ O time ainda está pequeno e a complexidade operacional precisa ser mantida baixa. Assim, o Prometheus em modo single-node roda com pouco esforço e cobre as necessidades iniciais de um guia de monitoramento de TI bem estruturado.
➡️ Você depende de bibliotecas específicas da comunidade Prometheus (exporters oficiais para PostgreSQL, MySQL, NGINX, RabbitMQ) que já vêm instrumentadas no formato nativo.
Quando usar OpenTelemetry?
OpenTelemetry passa a fazer sentido e, em muitos casos, torna-se obrigatório, quando o cenário exige mais do que métricas:
➡️ Você precisa de instrumentação unificada de aplicações em múltiplas linguagens (Java, Go, Python, .NET, Node.js). Dessa forma, o time de desenvolvimento mantém um padrão único, sem reinventar agentes para cada tecnologia.
➡️ O objetivo é correlacionar os três sinais (métricas, logs e traces) para acelerar análise de causa raiz. Tracing distribuído é, inclusive, pré-requisito em arquiteturas de microsserviços. Somente o OTel entrega uma instrumentação padronizada e portátil.
➡️ A empresa está planejando uma migração de backend de observabilidade e quer evitar reinstrumentação em produção. O movimento pode sair, por exemplo, de uma ferramenta comercial para open source, ou o contrário. Instrumentar com OTel hoje garante que, amanhã, a troca seja decisão operacional e não projeto de 12 meses.
➡️ Você opera ambientes híbridos com aplicações legadas, serverless e containers no mesmo pipeline. O Collector aceita receivers de diversos formatos (Jaeger, Zipkin, Prometheus, StatsD) e consolida tudo em OTLP.
Como usar OpenTelemetry e Prometheus juntos
A arquitetura mais adotada em 2026 não escolhe um ou outro. Combina ambos, aproveitando o melhor de cada um. Duas integrações merecem atenção. Em seguida, o laboratório que mediu as duas fecha a seção.
Prometheus 3.x como backend OTLP nativo
A partir da versão 3.0, o Prometheus aceita métricas no formato OTLP diretamente, via endpoint /api/v1/otlp/v1/metrics. Uma aplicação instrumentada com OTel envia métricas sem conversão intermediária. O Prometheus vira, assim, um backend OpenTelemetry de primeira classe para métricas.
Há um detalhe que derruba a primeira tentativa: o receptor OTLP vem desligado. A documentação oficial do Prometheus explica o motivo. O servidor pode rodar sem autenticação nenhuma, portanto aceitar escrita de fora por padrão seria imprudente.
Para medir o efeito, subimos dois containers da mesma imagem em 03/09/2026, o prom/prometheus:v3.13.2. A única diferença entre eles é a flag:
Ou seja, sem --web.enable-otlp-receiver o endpoint nem existe. O erro não é de payload nem de versão: é um 404 cuja mensagem diz exatamente o que falta.
Com a flag ligada, as métricas OTLP entram no TSDB e respondem a PromQL como qualquer outra série. A tela abaixo mostra, já dentro do Prometheus, o que a aplicação de teste enviou pelo Collector:
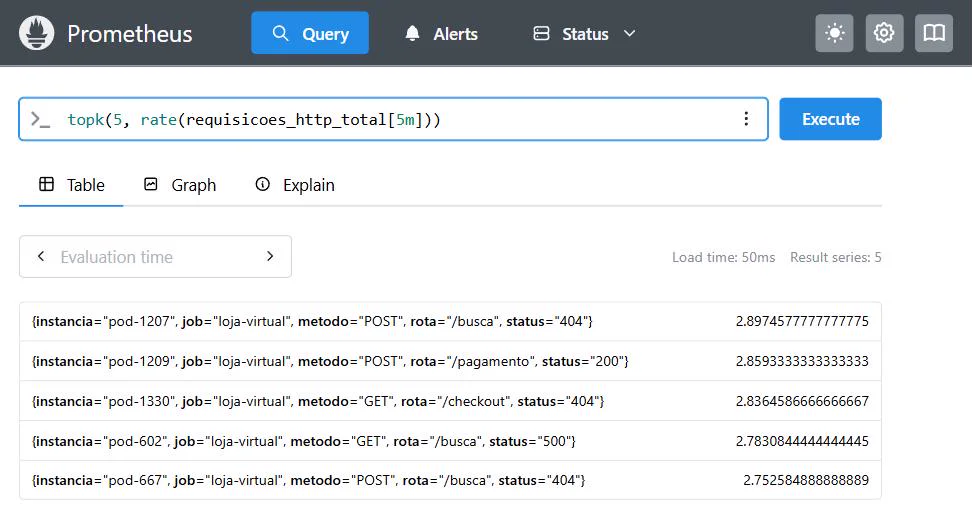
Repare no label job. O atributo service.name do OpenTelemetry vira job no Prometheus. Já service.instance.id vira instance. Os demais atributos do datapoint viram label com o mesmo nome.
OpenTelemetry Collector como ponte
Outra arquitetura comum usa o Collector como hub central. Aplicações instrumentadas com OTel enviam dados em OTLP para o Collector, que:
1. Aplica processors (filtragem, enriquecimento, amostragem)
2. Exporta métricas para o Prometheus, via otlphttp no endpoint nativo ou via prometheusremotewrite
3. Exporta traces para Jaeger ou Tempo
4. Exporta logs para Loki ou Elasticsearch
O pipeline abaixo é o que rodou no laboratório. Ele escreve direto no endpoint OTLP do Prometheus, sem prometheusremotewrite no meio:
Esse pipeline processou 480.000 datapoints no laboratório, sem nenhum recusado. O Collector gastou 2,07 segundos de CPU no total, ou seja, 4,31 ms por mil datapoints. A CPU do Collector, portanto, sai barata. A memória não sai, como mostra a seção de armadilhas.
Esse desenho, além disso, desacopla a instrumentação do backend e permite evoluir a arquitetura por partes. Para aprofundar a telemetria moderna com métricas, logs e traces, vale revisitar o pipeline completo.
O laboratório, em um docker-compose
Os números deste artigo saíram de um laboratório que sobe em dois containers. As versões medidas em 03/09/2026 foram o prom/prometheus:v3.13.2 e o otel/opentelemetry-collector-contrib:0.160.0.
O prometheus.yml pode ser mínimo, com apenas o global.scrape_interval. Já o otel-collector.yaml é o pipeline da seção anterior, sem nenhuma linha a mais.
Depois disso, um docker compose up -d deixa o receptor OTLP em localhost:4318 e o Prometheus em localhost:9090. A partir daí, qualquer aplicação instrumentada com OTel escreve no Prometheus sem código de cola.
Armadilhas comuns em produção
Nenhuma das duas ferramentas é plug-and-play em ambientes sérios. Algumas armadilhas aparecem repetidamente e merecem atenção antes de virarem incidentes. Três delas, inclusive, saíram deste laboratório com limiar medido, não com recomendação genérica.
Explosão de cardinalidade no Prometheus. Cada combinação única de labels gera uma série temporal, ou seja, cada label novo multiplica o que o TSDB guarda. No laboratório, o custo ficou estável em torno de 1,5 KB de memória residente por série ativa. A medição, inclusive, varreu de 10 mil a 1 milhão de séries.
| Séries ativas | Memória residente do processo | Custo por série |
|---|---|---|
| 10.000 | 99,9 MB | 1,6 KB |
| 50.000 | 160,8 MB | 1,6 KB |
| 100.000 | 229,6 MB | 1,5 KB |
| 250.000 | 475,5 MB | 1,6 KB |
| 500.000 | 849,8 MB | 1,6 KB |
| 1.000.000 nó dedicado | 1,45 GB | 1,4 KB |
A conta que importa, contudo, é a inversa. Por exemplo, cinco rotas, dois métodos e três status geram 30 séries. Basta acrescentar o user_id de 50 mil clientes para projetar 1,5 milhão de séries, ou cerca de 2,2 GB só de memória residente. Discipline o uso de labels desde o início.
Overhead do Collector mal dimensionado. Rodar um Collector em cada nó (modo agent) é simples, mas o gargalo não é a CPU. Com memory_limiter em 256 MiB, o processo medido segurava 225 MB de memória residente para apenas 28 MB de heap vivo.
Ou seja, o runtime do Go devolve memória ao sistema com atraso. Por isso, casar o limit_mib do processor com o limite do container mata o container. Configure sempre memory_limiter e batch. Depois disso, dê ao container folga sobre o limite do processor.
Sampling de traces agressivo demais. Traces completos em 100% do tráfego viram uma fatura absurda de storage. Por outro lado, sampling head-based muito baixo esconde os poucos casos de erro que realmente importam. Em síntese, a estratégia mais eficaz costuma ser tail-based sampling configurado no Collector.
Retenção desalinhada entre sinais. Métricas, logs e traces têm custos de armazenamento muito diferentes. O laboratório mediu o bloco já compactado do TSDB: 2,24 bytes por amostra, mais 129 bytes de índice por série.
A 15 segundos de intervalo, 90 dias custam 1,11 MB por série. Ou seja, dez mil séries pedem 10,8 GB só de métricas, antes de qualquer log ou trace. Defina políticas distintas: por exemplo, 30 dias de métricas, 14 dias de logs e 7 dias de traces com amostragem inteligente.
Ignorar o ecossistema existente. Empresas brasileiras raramente operam greenfield. A jornada realista costuma começar com Prometheus cobrindo infraestrutura e, gradualmente, introduzir OTel para instrumentar aplicações críticas com traces, não o contrário.
Logs, métricas e traces unificados para diagnóstico em profundidade.
Instrumentamos aplicações corporativas com OpenTelemetry para correlacionar eventos e acelerar a análise de causa raiz em produção.
Conclusão
A dúvida OpenTelemetry vs Prometheus deixa de existir quando se entende que cada um ocupa uma camada diferente do stack moderno de observabilidade.
Prometheus segue insubstituível como backend de métricas em ambientes cloud-native, especialmente em Kubernetes. OpenTelemetry, por sua vez, cresce como o padrão global de instrumentação, unificando os três sinais sob um mesmo protocolo.
O caminho pragmático para a maioria das empresas passa por adotar Prometheus primeiro, pela menor fricção operacional. Posteriormente, quando traces e logs entrarem na pauta, o OpenTelemetry entra com o Collector atuando como ponte.
A partir do Prometheus 3.x, essa integração ficou mais simples, com OTLP aceito nativamente a uma flag de distância. Os números deste artigo, vale destacar, saíram de um laboratório reproduzível, não de estimativa.
A sua equipe está desenhando uma estratégia de observabilidade? Para escolher, integrar e operar essas ferramentas com apoio, fale com um especialista OpServices e construa uma arquitetura sob medida.
Perguntas Frequentes
Qual a diferença entre OpenTelemetry e Prometheus?
OpenTelemetry substitui o Prometheus?
Posso usar OpenTelemetry e Prometheus juntos?
/api/v1/otlp) ou rodar o OpenTelemetry Collector como hub central, exportando métricas ao Prometheus e traces e logs a backends apropriados. Essa combinação une instrumentação padronizada pelo OTel com armazenamento de métricas eficiente pelo Prometheus.O Prometheus suporta OTLP nativamente?
/api/v1/otlp/v1/metrics. O receptor, porém, vem desligado: sem a flag --web.enable-otlp-receiver o endpoint responde 404, medido no Prometheus 3.13.2 em setembro de 2026. Com a flag ligada, o Prometheus vira backend OpenTelemetry de primeira classe para métricas e dispensa o exporter prometheusremotewrite do Collector.Qual deles é melhor para Kubernetes?