

Grafana: o que é, como funciona e como criar dashboards
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
O Grafana serve para reunir métricas, logs e traces em um painel só. Ele não coleta dado nenhum. Assim, conecta-se a quem já coleta, como o Prometheus, para transformar cada consulta em gráfico, tabela ou alerta.
Essa é a camada de visualização de uma estratégia de observabilidade. Na prática, o Grafana fica na frente do seu pipeline de telemetria e responde três perguntas: o que quebrou, quando começou e onde doeu.
Lançado em 2014 por Torkel Ödegaard, o projeto virou o padrão de facto do mercado. Hoje a Grafana Labs contabiliza 35 milhões de usuários, número divulgado em abril de 2026.
Neste guia você vai ver para que o Grafana serve, como a arquitetura funciona e como montar um dashboard com dado real. Vale destacar que todos os números e telas a seguir saíram de um laboratório em Docker. A versão testada foi o Grafana 13.0.2, em 2 de setembro de 2026.
O que é Grafana?
Grafana é uma plataforma open source de visualização, análise e monitoramento que liga dashboards interativos a várias fontes de dados simultaneamente. A interface nasceu baseada no Kibana 3, com foco em métricas. Depois disso, o projeto passou a cobrir logs, traces e alertas no mesmo painel.
Quem mantém o projeto é a Grafana Labs, que também desenvolve o ecossistema LGTM: Loki (logs), o próprio Grafana (visualização), Tempo (traces) e Mimir (métricas em escala). Dessa forma, o conjunto forma uma alternativa open source ao stack proprietário de fornecedores como Datadog ou New Relic.
Para aprofundar, a documentação oficial do projeto cobre instalação, configuração de data sources e alertas.

Arquitetura do Grafana: como funciona
Data Sources
O Grafana não armazena dados: ele se conecta a fontes externas via data sources. Ou seja, cada data source é um plugin que define como o Grafana consulta e interpreta os dados de um backend específico.
Na versão 13.0.2, a instalação padrão já traz 18 fontes de dados prontas. Elas cobrem métricas via Prometheus, Graphite e InfluxDB; logs via Loki; traces via Tempo, Jaeger e Zipkin. Além disso, entram os bancos SQL e as APIs das três grandes nuvens.
Surpreende a ausência do Elasticsearch. Na imagem grafana-oss dessa versão ele não vem instalado, portanto entra como plugin à parte.
| Pilar | Fontes que já vêm instaladas | Critério de escolha |
|---|---|---|
| Métricas | Prometheus, InfluxDB, Graphite, OpenTSDB |
Prometheus quando a coleta é por scraping em Kubernetes; InfluxDB quando a escrita vem de sensor ou IoT em alta frequência |
| Métricas de nuvem | CloudWatch, Azure Monitor, Google Cloud Monitoring |
Serviço gerenciado que não expõe endpoint próprio, então o dado só existe dentro da nuvem |
| Logs | Loki |
Loki indexa label, não o texto inteiro, e por isso custa menos que busca full-text |
| Traces | Tempo, Jaeger, Zipkin |
Tempo integra com Loki pelo mesmo rótulo; Jaeger e Zipkin quando o rastro já existe na stack |
| Perfis de código | Pyroscope, Parca |
Consumo de CPU e memória linha a linha, quando a métrica já apontou o serviço culpado |
| Banco SQL | PostgreSQL, MySQL, SQL Server |
Cruzar sinal técnico com dado de negócio, como pedido em fila ou contrato ativo |
| Alertas | Alertmanager |
Ler no Grafana o alerta que o Prometheus já dispara, sem duplicar a regra |
Essa arquitetura de plugins torna o Grafana agnóstico de fornecedor. Assim, a mesma instalação lê Prometheus, InfluxDB e Loki no mesmo dashboard. Cabe ressaltar que conectores para plataformas proprietárias, como o do Datadog, são plugins Enterprise e exigem licença paga.
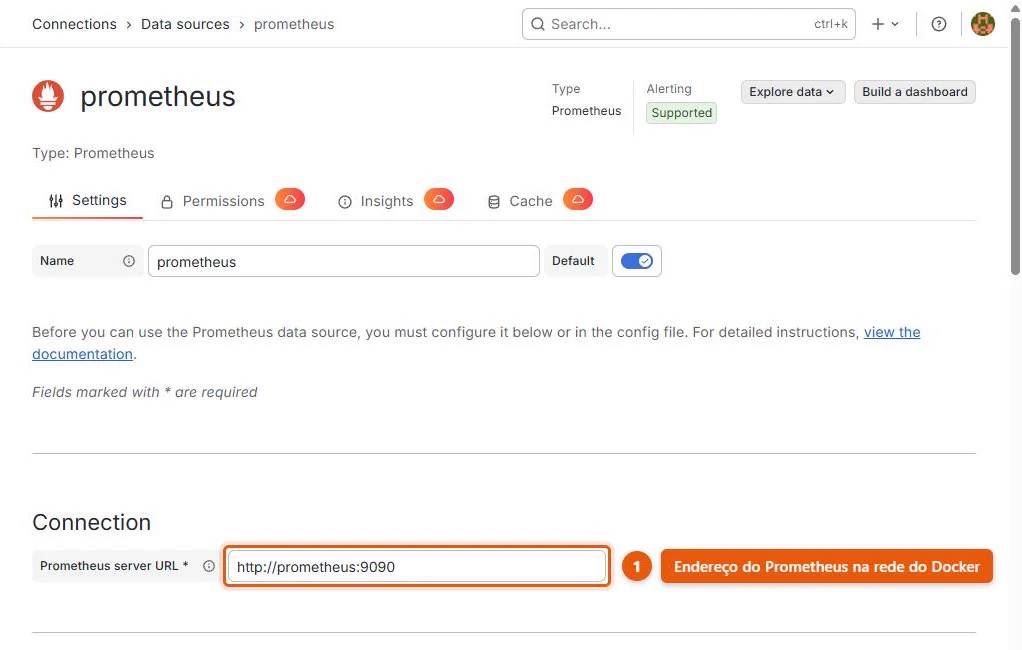
Conectar uma fonte exige apenas o tipo e o endereço do backend. Por exemplo, a tela abaixo mostra o Prometheus ligado a uma instalação local, com o endereço apontando para o serviço dentro da rede do Docker.
Dashboards e painéis
Todo dashboard do Grafana é composto por painéis (panels). Cada painel é uma visualização independente, com a sua própria consulta, tipo de gráfico e estilo. A versão 13.0.2 traz 27 tipos prontos. Por isso, escolher errado entre eles é o que faz um dashboard bonito não responder nada.
| Tipo de painel | A pergunta que ele responde | Erro comum |
|---|---|---|
| Time series | Como esse número se comportou ao longo do tempo? | Plotar dezenas de séries sem agregação, o que vira emaranhado ilegível |
| Stat | Qual é o valor agora, e ele subiu ou desceu? | Usar para grandeza que oscila muito, porque o valor exibido depende do instante |
| Gauge | Quanto falta para estourar o limite? | Aplicar a métrica sem teto conhecido, já que o medidor precisa de mínimo e máximo |
| Table | Quais itens estão fora do padrão, item a item? | Deixar sem ordenação, porque a linha que importa some no meio das outras |
| Heatmap | Como os valores se distribuem, não só a média? | Trocar por média simples, que esconde a cauda onde mora a latência ruim |
| State timeline | Quanto tempo o serviço passou em cada estado? | Usar para valor contínuo, quando ele só funciona com estado discreto |
| Logs | O que a aplicação escreveu na hora do pico? | Abrir janela larga demais e trazer milhares de linhas sem filtro de label |
| Node Graph | Quem chama quem, e onde o tempo se perde? | Esperar que ele funcione sem trace instrumentado por trás |
O Grafana usa uma linguagem de consulta específica por data source. Por exemplo, o Prometheus responde a PromQL, o Loki a LogQL e o Elasticsearch à Query DSL. Assim, o Grafana transforma essas consultas em visualização sem que o engenheiro escreva código de frontend.
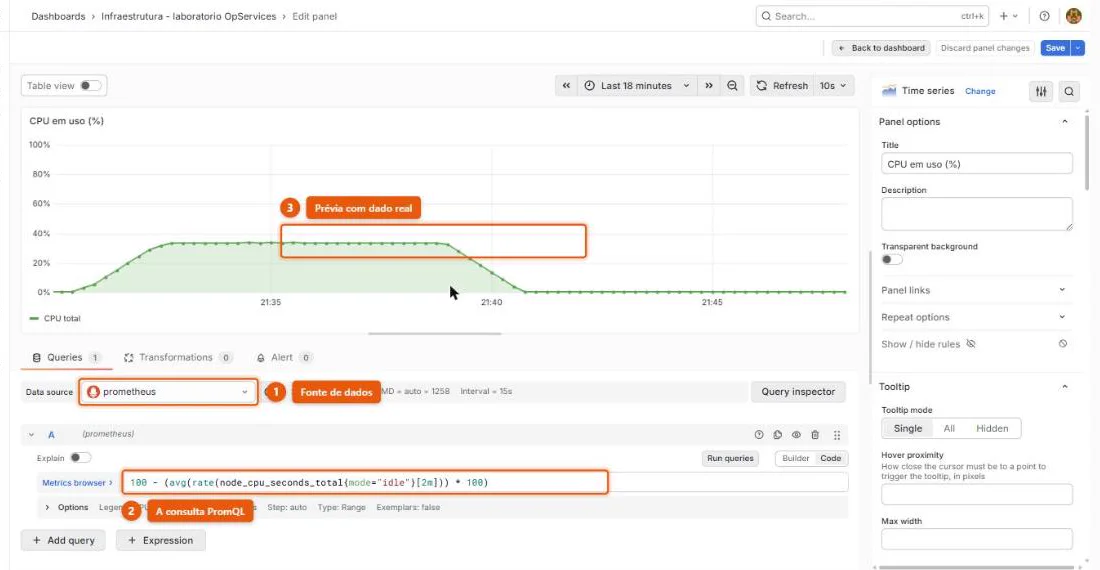
No editor de painel os três elementos ficam numa tela só: a fonte de dados, a consulta e a prévia do resultado. Por exemplo, na tela abaixo uma consulta PromQL de uso de CPU aparece no modo Code enquanto o gráfico responde a cada alteração.
No OpCast #05, Miguel Moraes mostra como o design de um dashboard muda a leitura do painel. Além disso, ele aponta onde a IA entra na criação.
Alertas
O sistema de alertas unificado do Grafana (módulo Alerting) permite definir alerta sobre qualquer data source. Ou seja, um alerta é uma regra que avalia uma consulta de tempos em tempos e dispara notificação quando a condição se cumpre. Por exemplo, quando o P95 de latência supera 300ms por mais de 5 minutos.
Na notificação, o Grafana cobre vários canais: PagerDuty, Opsgenie, Slack, email e webhooks. Dessa forma, somado a uma estratégia de escalonamento de alertas, ele se torna o ponto central de disparo de incidentes.
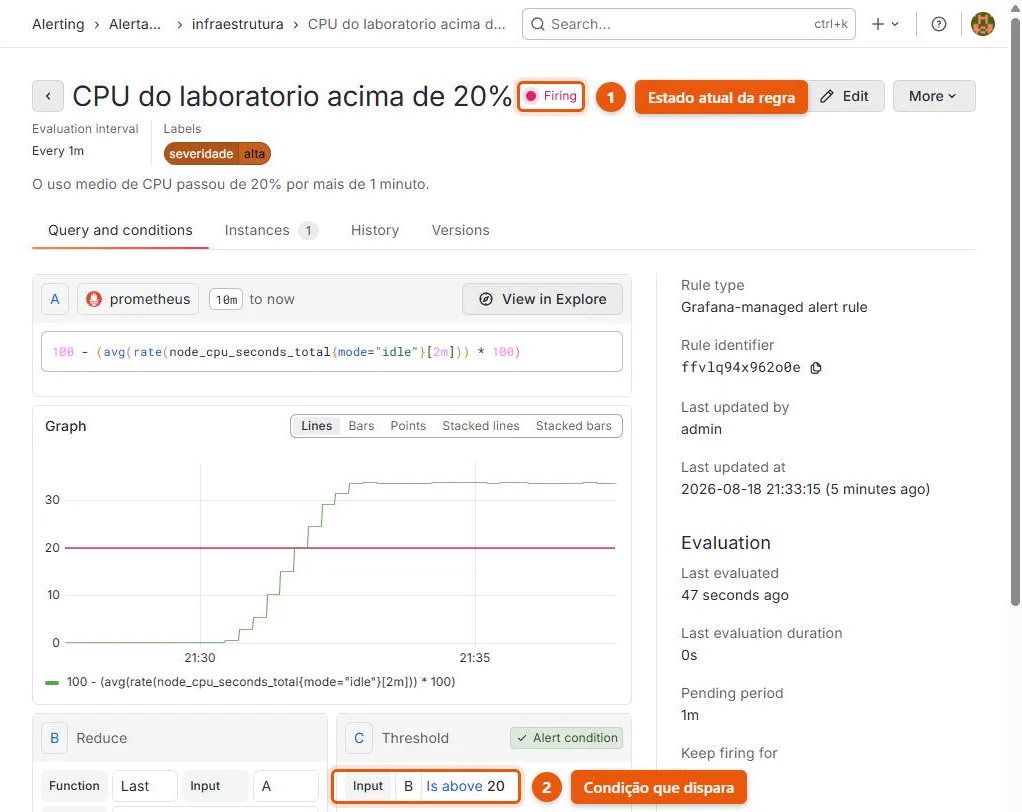
Na tela da regra aparece o ciclo inteiro: a consulta que alimenta a avaliação, o limite configurado e o estado atual. Enquanto a condição se mantém pelo período definido, a regra passa de Pending para Firing. Em seguida, a notificação sai.
Ebook: Como sobreviver à fatura cloud?
Nosso framework, Observability Maturity Index, mede a maturidade das operações em nuvem das empresas. Você encontrará: os quatro perfis de empresas, as métricas que você deveria estar medindo, um checklist de avaliação e um plano de ação para 90 dias.
Só o e-mail. Sem spam, e seus dados protegidos pela LGPD.
Grafana e Prometheus: a integração fundamental
A combinação Grafana + Prometheus é o stack de monitoramento mais comum em ambientes Kubernetes e cloud-native. Nessa divisão, o Prometheus cuida da coleta e do armazenamento via scraping, ao passo que o Grafana cuida da visualização e dos alertas.
O fluxo tem três tempos. Antes de tudo, as aplicações expõem métricas no formato Prometheus pelo endpoint /metrics. Em seguida, o Prometheus faz o scrape delas. Por fim, o Grafana consulta o Prometheus via PromQL e desenha os dashboards.
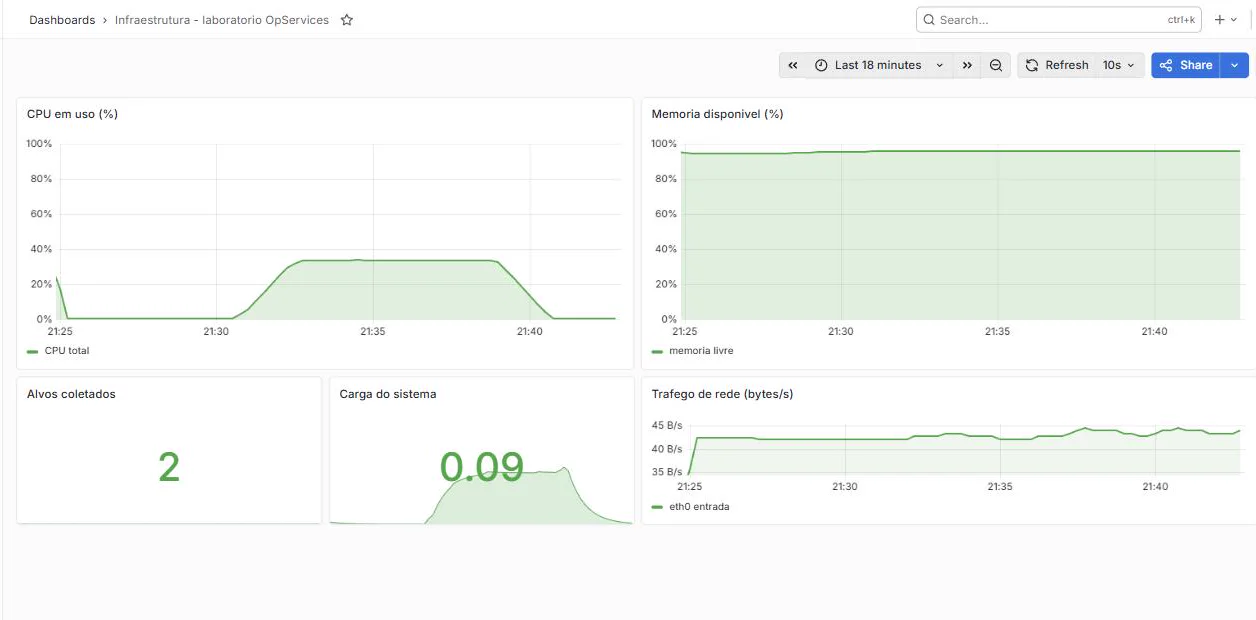
Como resultado, sai um painel como o abaixo, montado sobre um Prometheus que coleta um node exporter. Vale dizer que o degrau no gráfico de CPU veio de uma carga real aplicada ao host. Não é dado de exemplo.
Para times que usam OpenTelemetry, o pipeline se expande: as aplicações exportam métricas via OTLP para o OTel Collector, que as converte para o formato Prometheus ou as envia diretamente para Mimir. Em qualquer um dos caminhos, o Grafana visualiza os dados da mesma forma.
Como criar um dashboard no Grafana, passo a passo
O caminho abaixo sai do zero e termina com um painel de CPU real na tela. Ele foi executado em 2 de setembro de 2026, no Grafana 13.0.2 com Prometheus. Ou seja, cada número citado saiu dessa execução.
1. Suba a stack. Antes de tudo, crie uma pasta, salve nela os dois arquivos abaixo e rode docker compose up -d. São três containers: o Prometheus coleta, o node exporter expõe as métricas da máquina e o Grafana desenha.
2. Ligue a fonte de dados. Em seguida, abra http://localhost:3300, entre com o usuário e a senha do compose e vá em Connections, Data sources, Add new data source. Escolha Prometheus e preencha o campo Prometheus server URL.
Atenção ao endereço certo: http://prometheus:9090, o nome do serviço. Dentro da rede do Docker, localhost aponta para o próprio container do Grafana. Por isso essa é a primeira parede em que todo mundo bate.
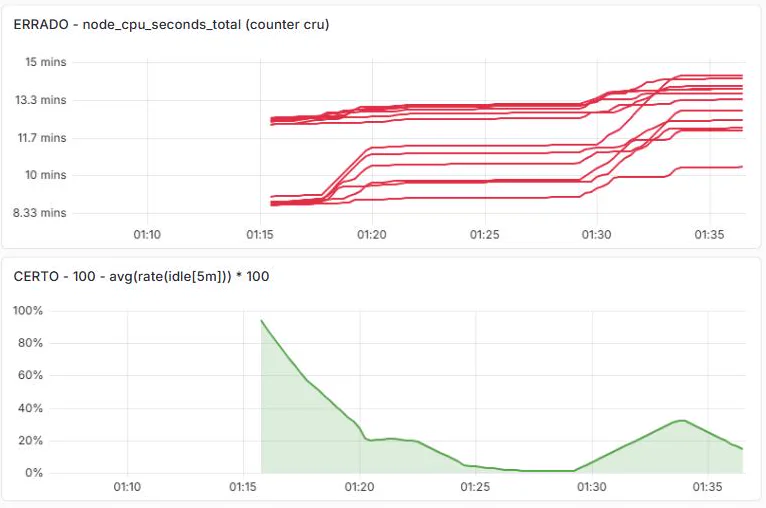
3. Escreva a consulta certa. Depois disso, crie um painel novo e escolha o data source. Aqui mora o erro que mais estraga dashboard de CPU: usar o counter cru no lugar da derivada dele.
Os dois painéis abaixo consultam a mesma métrica, no mesmo intervalo. O de cima soma segundos desde o boot, portanto sobe para sempre e ignora a carga. Por outro lado, o de baixo aplica rate() e mostra o episódio inteiro: repouso, pico de 31% e volta ao repouso.
4. Ajuste a unidade antes de salvar. No painel de baixo, em Standard options, escolha Percent (0-100) e trave o eixo entre 0 e 100. Sem isso o gráfico reescala sozinho a cada atualização. Assim, um pico de 3% ocupa a tela toda e parece incidente.
5. Salve e nomeie. Por fim, clique em Save dashboard e dê um nome que diga o escopo, por exemplo “Infra, node exporter”. Todo dashboard do Grafana é um JSON. Portanto, versionar esse arquivo é o que permite recriar o painel em outro ambiente sem refazer clique nenhum.
Grafana no contexto da observabilidade moderna
Numa arquitetura de observabilidade, o lugar do Grafana é o de camada de visualização unificada. Ou seja, ele não substitui Prometheus, Loki, Tempo ou Jaeger: conecta os quatro em uma navegação única.
Daí vem a correlação entre pilares. De um pico de latência no gráfico de métricas, você pula para os logs do serviço no mesmo período, via Loki. Em seguida, chega aos traces da requisição afetada, via Tempo, sem sair do dashboard.
Em suma, é essa correlação que materializa a observabilidade end-to-end no dia a dia da operação.
Cabe ressaltar um ponto que gera confusão frequente: o Grafana não é um projeto da CNCF. Desde 2021 ele carrega licença AGPLv3, ao passo que a fundação exige Apache 2.0 nos projetos que hospeda. Quem está na CNCF é a camada de coleta ao lado dele, como o Prometheus, graduado em 2018.
Grafana Cloud vs. Grafana self-hosted
São duas as formas de implantar o Grafana. A primeira é o Grafana self-hosted, que roda na infraestrutura própria, como binário, container Docker ou chart Helm para Kubernetes. Assim, atende times com restrição de compliance ou que preferem controle total.
Por outro lado, o Grafana Cloud é a versão gerenciada da Grafana Labs. O tier gratuito traz 10 mil séries de métricas ativas, 50 GB de logs, 50 GB de traces e 14 dias de retenção. Além disso, inclui alertas, dashboards e integrações prontas para as principais nuvens.
Para times que estão iniciando uma estratégia de dashboards de observabilidade, o Grafana Cloud no tier gratuito é o ponto de partida mais rápido: não requer infraestrutura própria e já inclui Loki, Tempo e Mimir configurados.
Logs, métricas e traces unificados para diagnóstico em profundidade.
Instrumentamos aplicações corporativas com OpenTelemetry para correlacionar eventos e acelerar a análise de causa raiz em produção.
Conclusão
Hoje o Grafana é a camada de visualização padrão de uma estratégia de observabilidade. Ele liga dezenas de fontes de dados em dashboards unificados, com correlação entre métricas, logs e traces. Por isso ocupa o centro da mesa de times de SRE e DevOps que precisam diagnosticar incidente rápido.
Em resumo, a combinação Grafana + Prometheus + OpenTelemetry é o stack open source mais adotado em ambiente cloud-native. Para estruturar essa estratégia e integrar o Grafana ao seu ambiente de produção, fale com nossos especialistas.
Perguntas Frequentes
O que é Grafana?
Qual a diferença entre Grafana e Prometheus?
Grafana é gratuito?
Como o Grafana se integra com OpenTelemetry?
O que é o stack LGTM do Grafana Labs?
